Action Chunking 与 Temporal Ensemble
1. 复合误差问题(Compounding Errors)
在单步策略中,模型每一步都独立决策:π_θ(a_t | s_t)。这种"一步一步来"的方式看起来很自然,却有一个致命缺陷:
早期的小错误会在后续步骤中不断被放大,最终导致长期轨迹显著偏离预期。
单步策略的"误差滚雪球"过程:
动作 a₁ 预测出现小偏差 ✕
        ↓
动作 a₂ 基于错误状态,偏差放大 ✕✕
        ↓
动作 a₃ 偏差继续累积 ✕✕✕
        ↓
轨迹彻底偏离目标 ✗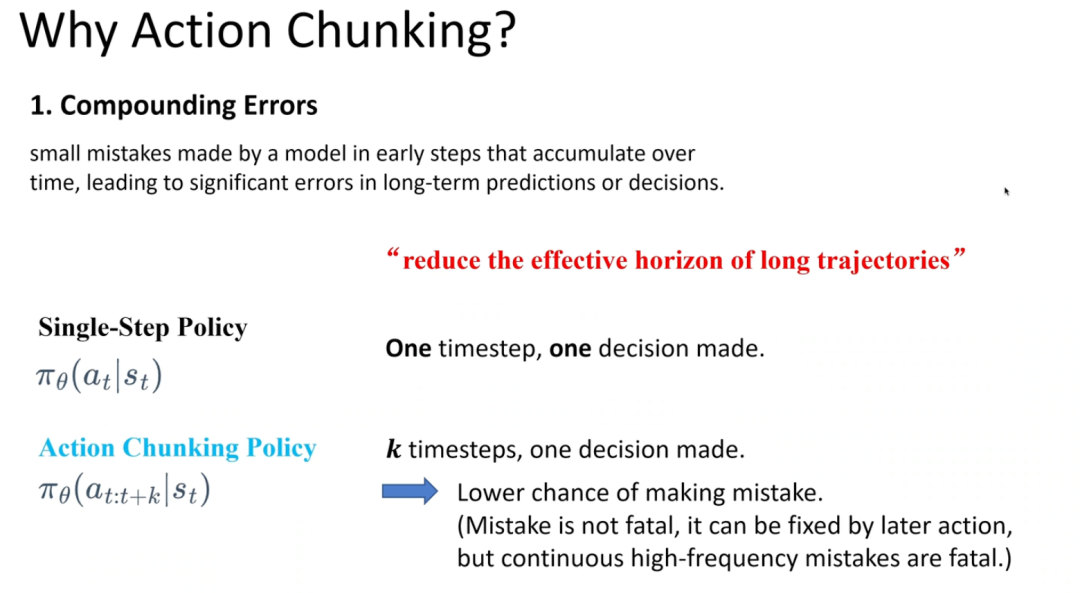
Action Chunking 的解法:一次预测未来 k 步
Action Chunking 策略改为一次预测未来 k 步:π_θ(a_t:t+k | s_t)。
单步策略                          Action Chunking
每步独立决策,误差滚雪球     →     一次决策 → a₁, a₂, a₃, …, aₖ
                                 决策次数减少 k 倍,误差输入窗口更小
                                 偶发小错误可在块内被后续动作修正
                                 块与块之间由 Temporal Ensemble 平滑衔接 ✓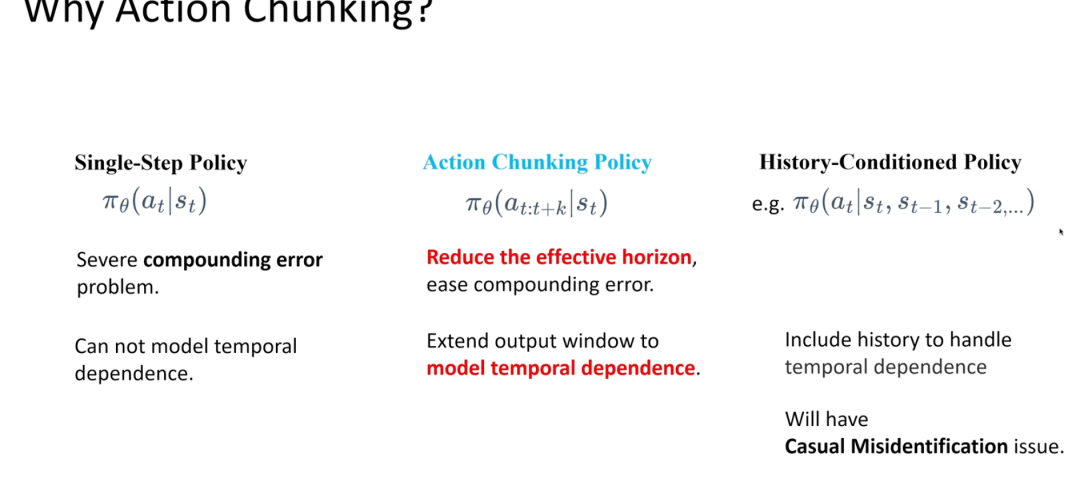
它减少了决策次数,也就是缩短了策略的"有效时域"(Effective Horizon),从而降低了复合误差的风险。需要注意的是:偶尔的小错误可以被后续动作修正,但连续高频错误仍然是致命的。
2. 非马尔可夫行为(Non-Markov Behavior)
马尔可夫假设认为未来只依赖于当前状态:P(a_t | s_t, s_t-1, ...) = P(a_t | s_t)。然而真实任务往往具有非马尔可夫性,例如:
"倒油后,需要等待 3 秒让油热,然后再翻炒。"
| 动作 | 画面表现 | 决策依据 |
|---|---|---|
| 动作 1 · 倒油 🥘 | 画面变化明显 | 只看当前帧即可判断 |
| 动作 2 · 等待 3 秒 ⏱️ | 画面几乎不变 | 仅靠当前帧无法判断该做什么 |
| 动作 3 · 翻炒 🍳 | 依赖历史上下文 | 依赖"已倒油且等待完成"的历史 |
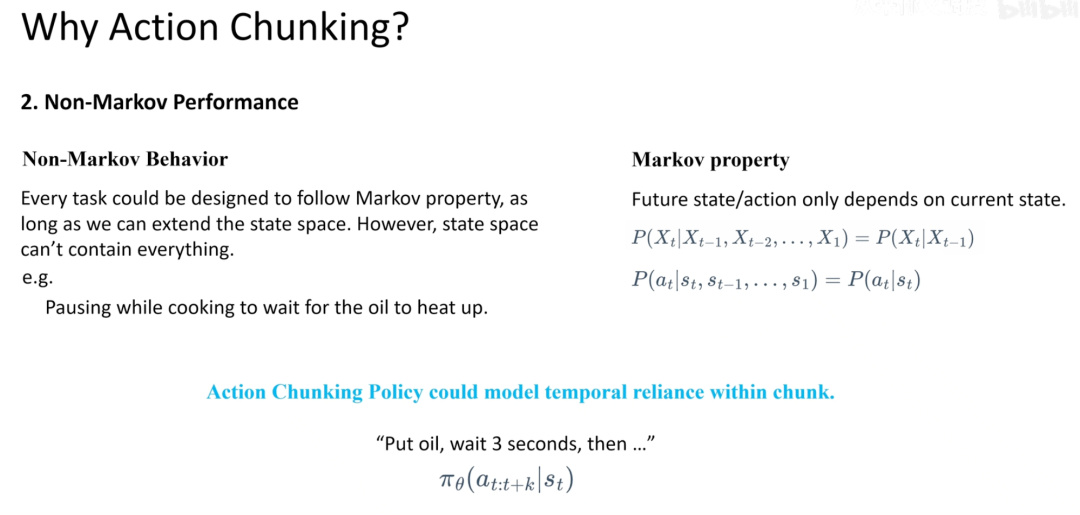
这种"等待"动作无法仅由当前画面决定,必须依赖历史上下文。Action Chunking 让模型在一个 chunk 内建模时序依赖关系,从而表达"先倒油、等待、再翻炒"这样的连续行为。
3. Temporal Ensemble:让动作更平滑
当模型以固定窗口大小 k 滑动预测时,相邻两个 chunk 之间会存在重叠的动作。如果直接执行最新 chunk 的前几个动作,可能会在 chunk 边界处产生抖动。
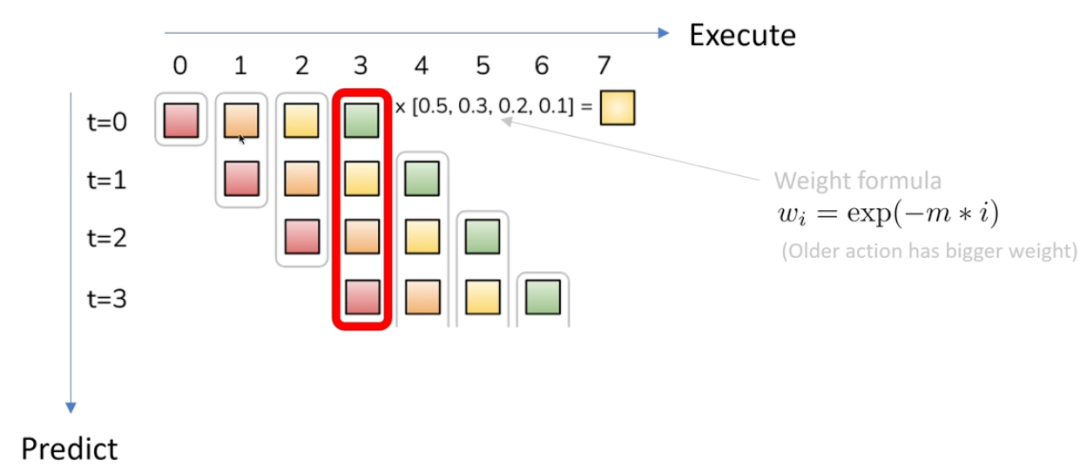
重叠窗口加权融合
w_i = exp(-m · i)其中 i 表示动作距离当前时刻的偏移,越"旧"的动作权重越大,保证执行动作的连续与平滑。
如图所示,t=0 预测的动作序列与 t=1、t=2 等预测序列在重叠位置按指数权重进行加权平均,最终得到一条更稳定、更平滑的执行轨迹。
小结
| 问题 | 方案 |
|---|---|
| 复合误差:逐步决策误差累积 | 一次预测 k 步,决策次数减少 k 倍 |
| 非马尔可夫:等待类动作依赖历史 | chunk 内部建模时序依赖 |
| chunk 边界抖动 | Temporal Ensemble 指数加权融合重叠区 |